近日,晶晨半导体(Amlogic)正式上线 Amlogic AI 开发者门户(amlogic-nn.github.io),并在 GitHub 上开放了 Amlogic-NN 开源组织。门户首页写着一句很直接的话——“Build on the edge. Start here.”,意思是在晶晨芯片上做端侧 AI 开发,从这里开始就够了。开发要用到的模型、工具、文档和性能数据,现在都集中在一个地方,不用再到处翻找。
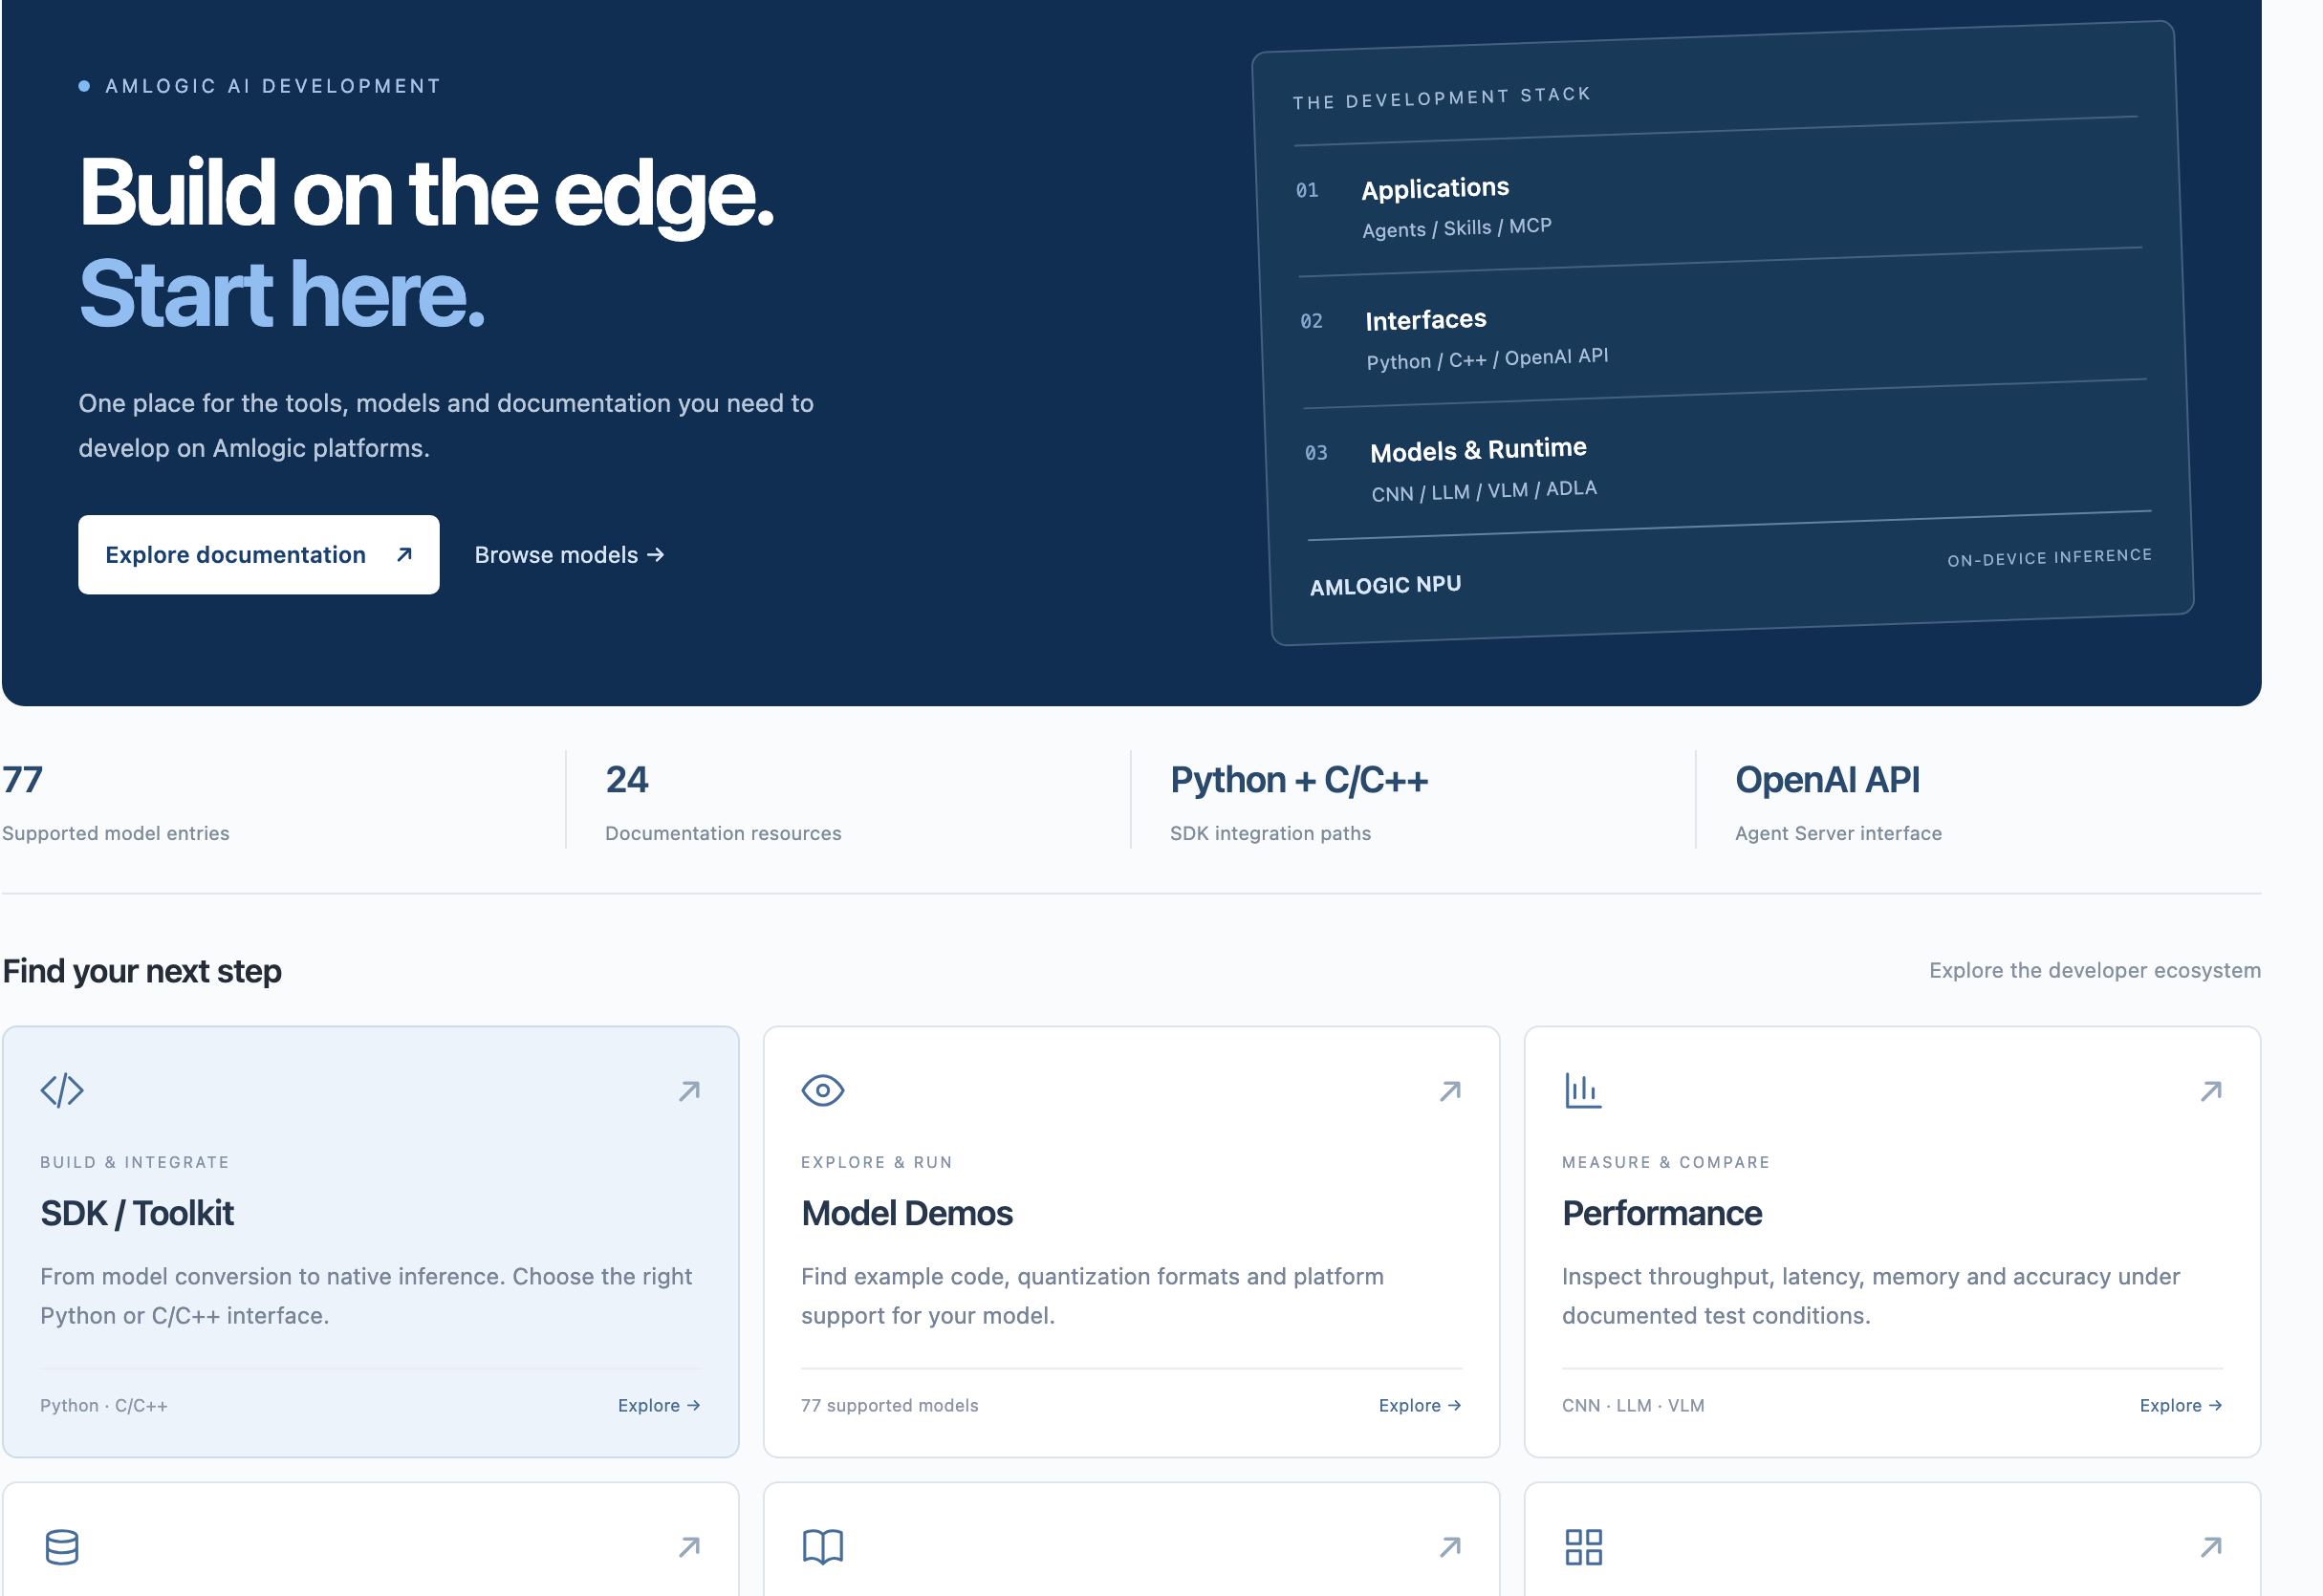
图 1 Amlogic AI 开发者门户首页:技术栈、核心数据与六大入口
一、六个入口,把开发流程串起来
门户首页放了六个入口,基本对应开发者从拿到芯片到做出产品的完整过程:
SDK / Toolkit:从模型转换到原生推理,提供 Python 和 C/C++ 两种接口;
Model Demos:77 个模型示例,能直接看到量化格式和平台支持情况;
Performance:CNN、LLM、VLM 的吞吐量、延迟、内存和精度实测数据;
ADLA Hub:预处理好的模型仓库,在 Hugging Face 和 ModelScope 上都有镜像;
Doc Center:24 份文档,包括快速上手、API 参考、算子列表和部署指南;
Agent Examples:Agent 集成文档和参考场景。
首页上还摆着四个数字:77 个已适配的模型条目、24 份文档资源、Python + C/C++ 两条 SDK 集成路径,以及一套兼容 OpenAI API 的 Agent Server 接口。
二、77 个模型 Demo,常用模型基本都在
Model Demos 页目前有 77 个模型条目(页面筛选栏共显示 78 个资源,其中 77 个是模型,另有 1 份平台构建指南)。分类覆盖图像分类、音频、目标检测、姿态手势、语义分割、车牌识别、OCR、图文模型、LLM 和 VLM。常用的基本都能找到:检测有 YOLOv5 到 v11、YOLOX、YOLO-World、PP-YOLOE、YOLOE;人脸有 RetinaFace;分割有 DeepLabV3、PP-LiteSeg、MobileSAM;姿态有 BlazePose;OCR 有 PaddleOCR v4/v5;语音和多模态有 Whisper、CLIP 等。每个 Demo 都写了转换、部署和推理的步骤,并标注了量化格式和支持的平台,照着做就能跑。
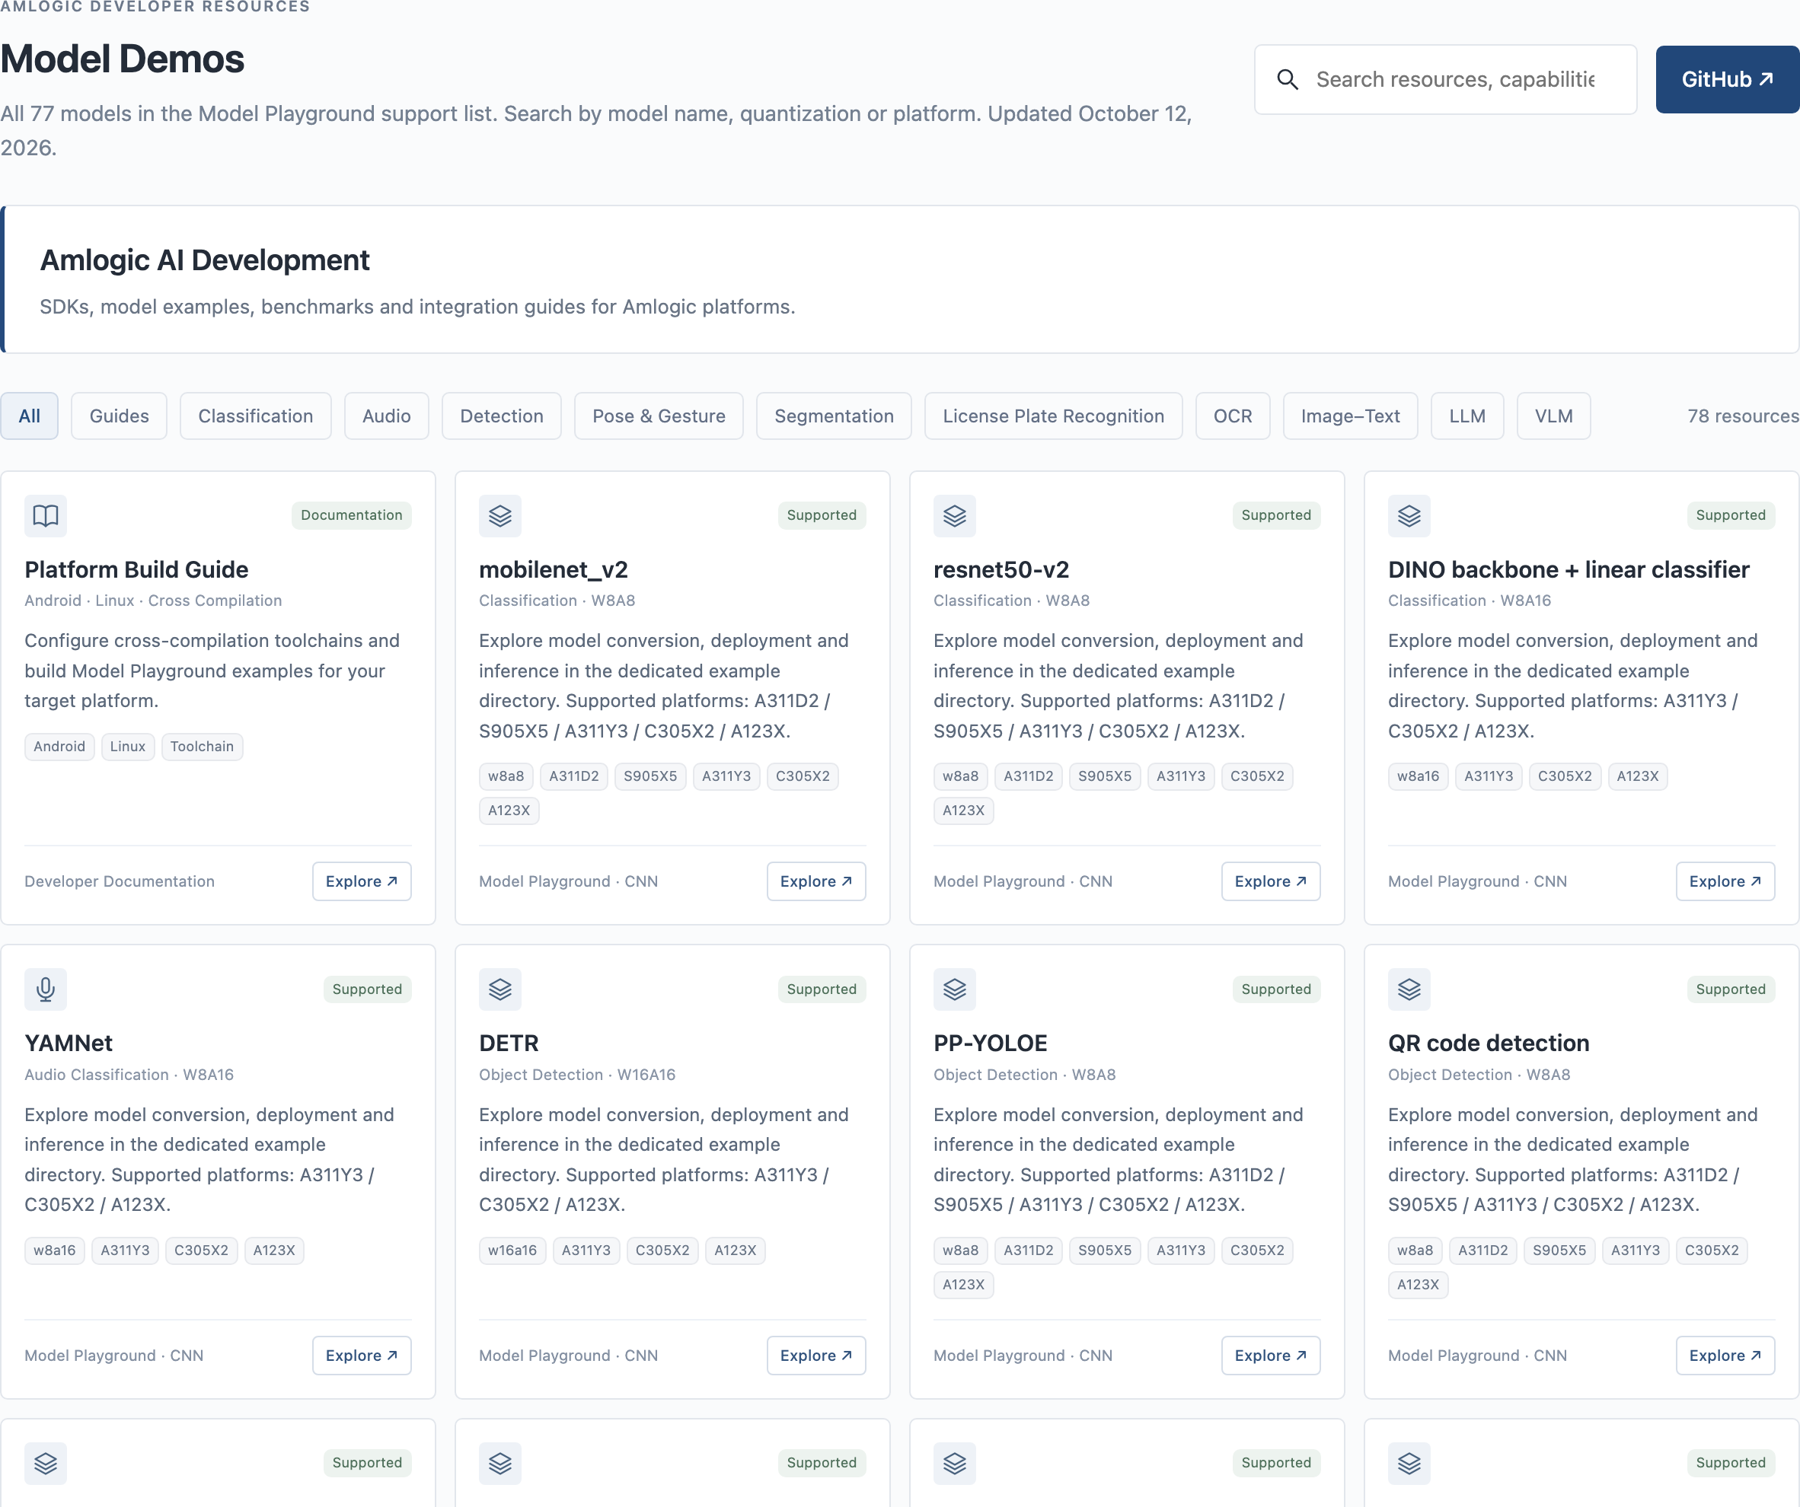
图 2 Model Demos:77 个模型条目,可按任务类型和平台筛选
三、工具链:Python 和 C/C++ 两条路都留好
SDK 部分提供了六件工具,做原型和做量产都能用:
Amlogic NN Toolkit:模型转换、量化、编译、推理的全链路工具;
NN Edge Toolkit Lite:在开发板上用 Python 跑 CNN 的轻量工具,适合快速验证;
LLM Edge Toolkit Lite:支持流式输出、多轮对话、采样参数和 chat template;
Amlogic Agent Server:兼容 OpenAI API 的端侧 LLM/VLM 服务,支持流式、工具调用、ASR、KV-cache 复用,还提供端云路由的实验特性;
NN Runtime C/C++:libnnsdk.so + nnsdk2.h,支持 Android 和 Linux;
LLM Runtime C/C++:libllmsdk.so + llmsdk.h,通过回调实现流式输出。
原型阶段用 Python 几天就能把想法跑通,量产阶段可以切到 C/C++ 接口把性能和内存做扎实。
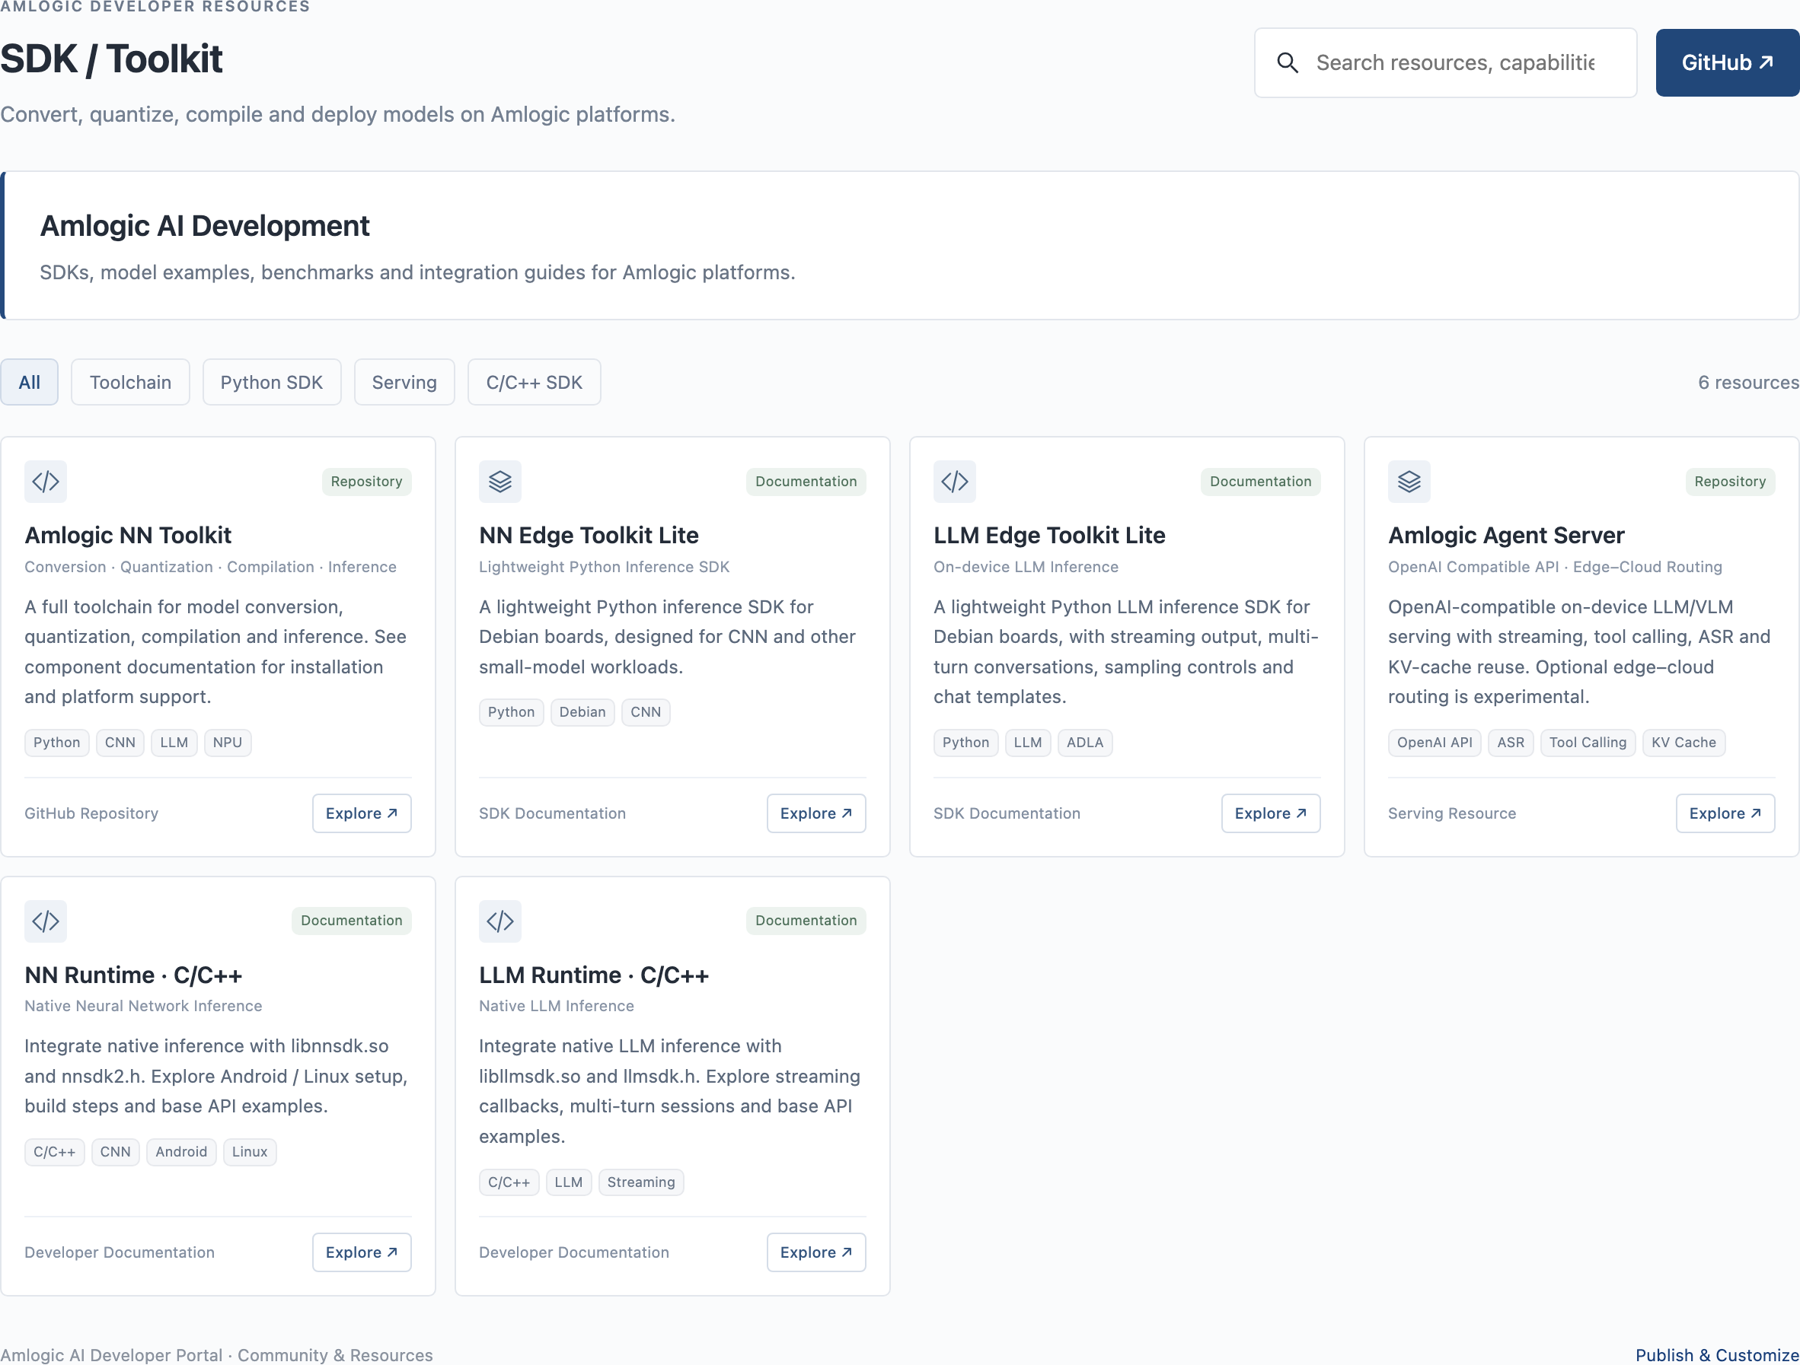
图 3 SDK / Toolkit:六件工具覆盖 Python 与 C/C++ 两条开发路径
四、模型直接下载,Hugging Face 和 ModelScope 都有
ADLA Hub 提供预处理好的模型包,在 Hugging Face(Amlogic-NN/amlnn-adla-models)和 ModelScope(Amlogic/amlnn-adla-models)上各有一个仓库,Agent Server 也支持启动时直接下载。量化精度按平台做了区分:新平台 A311Y3、C305X2、A123X 支持 W8A16 和 W16A16,A311D2 和 S905X5 支持 W8A8。
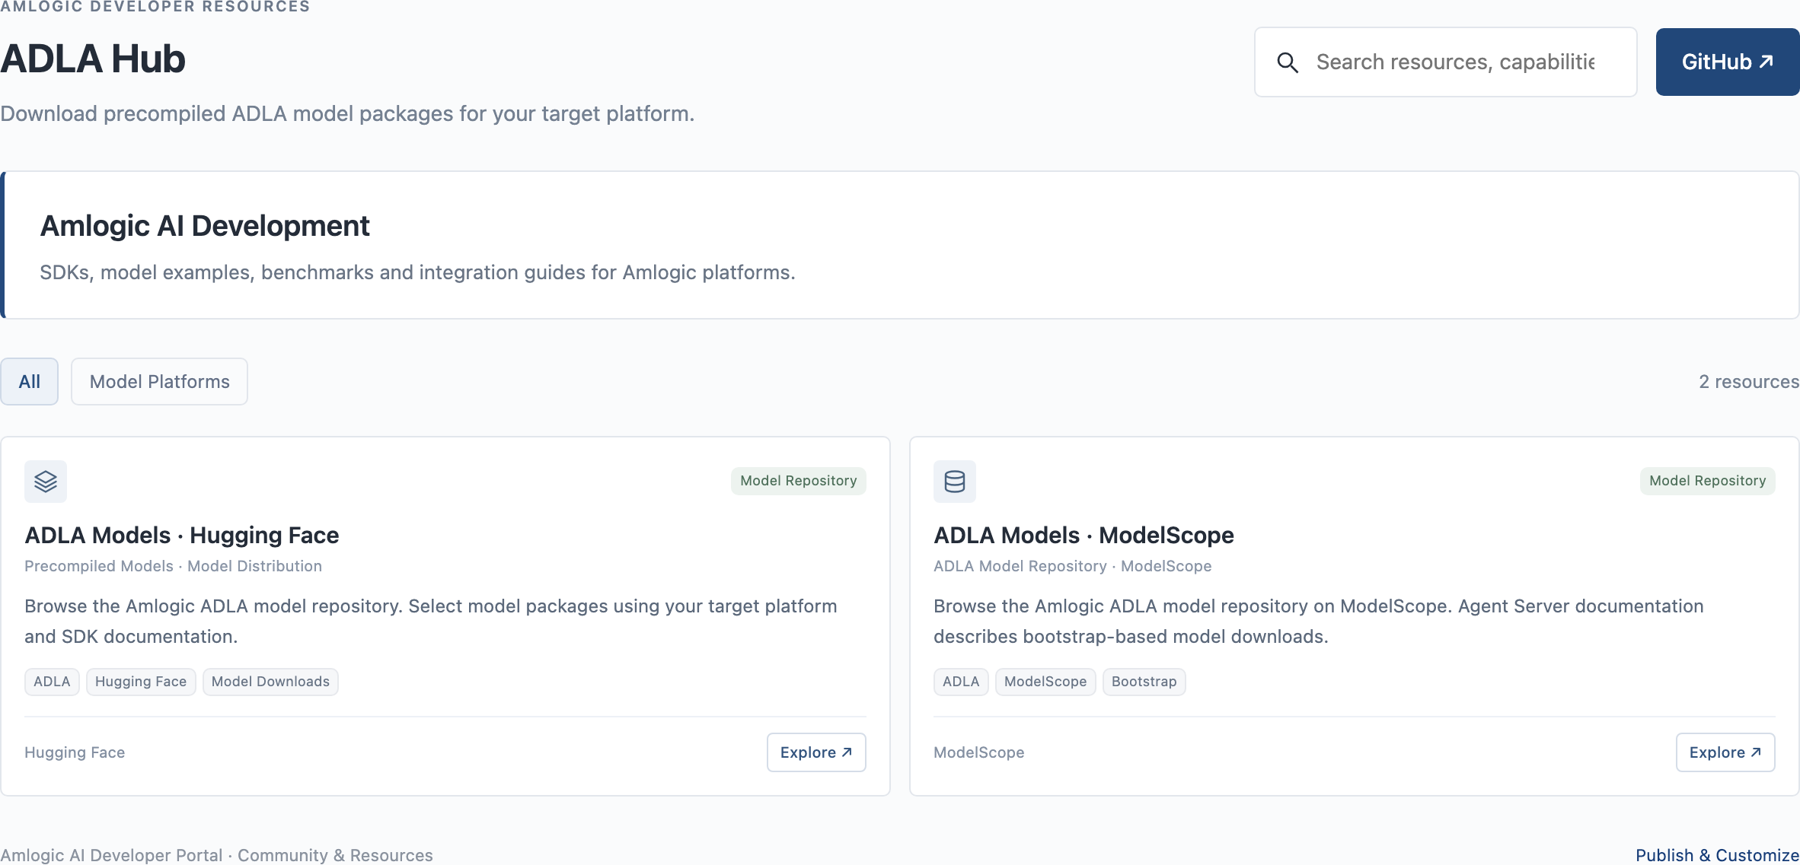
图 4 ADLA Hub:模型在 Hugging Face 和 ModelScope 双仓库提供
五、性能数据全部公开,测试条件写清楚
Performance 页不是几张营销图,而是完整的实测数据库,包含五个子页:CNN 吞吐量、LLM/VLM 运行时、CNN 精度、LLM 困惑度和 MMLU 精度,还能按平台筛选、导出 CSV。数据快照时间是 2026 年 10 月 12 日。
以 A311Y3 SoC(晶晨新一代平台,Armbian 参考板,W4A16)为例:
CNN 方面,mobilenet_v2 跑到 1014.2 FPS,resnet50 为 266.9 FPS,yolov8n 为 191.1 FPS,yolov8s 为 83.1 FPS,BlazePose 关键点模型 328.4 FPS,Whisper tiny decoder 51.6 FPS,CLIP ViT-Base 73.0 FPS;
大模型方面(按 Seq64、Context320、Output256 配置),Gemma3-270M 为 86.4 tokens/s,MiniCPM4-0.5B 为 72.9 tokens/s,Qwen2-0.5B 为 63.6 tokens/s,DeepSeek-R1-1.5B 为 22.7 tokens/s,Qwen-VL2-2B 为 22.9 tokens/s,Qwen3-4B 为 9.0 tokens/s,Llama2-7B 为 5.4 tokens/s,MiniCPM-V 2.6-8B 为 2.1 tokens/s;
精度方面,ResNet50 在 W8A16 下 Top1 为 75.9%(W8A8 为 72.4%);MMLU(5-shot,500 样本)中 Qwen3-4B-Thinking 为 0.814(相对参考有 4% 增益)、Qwen3-4B-Instruct 为 0.730。
从几百兆的小模型到 70 亿、80 亿参数的模型,在这块板子上能跑到什么水平,门户里都有同口径的数字可查,客户做选型不用再靠估算。
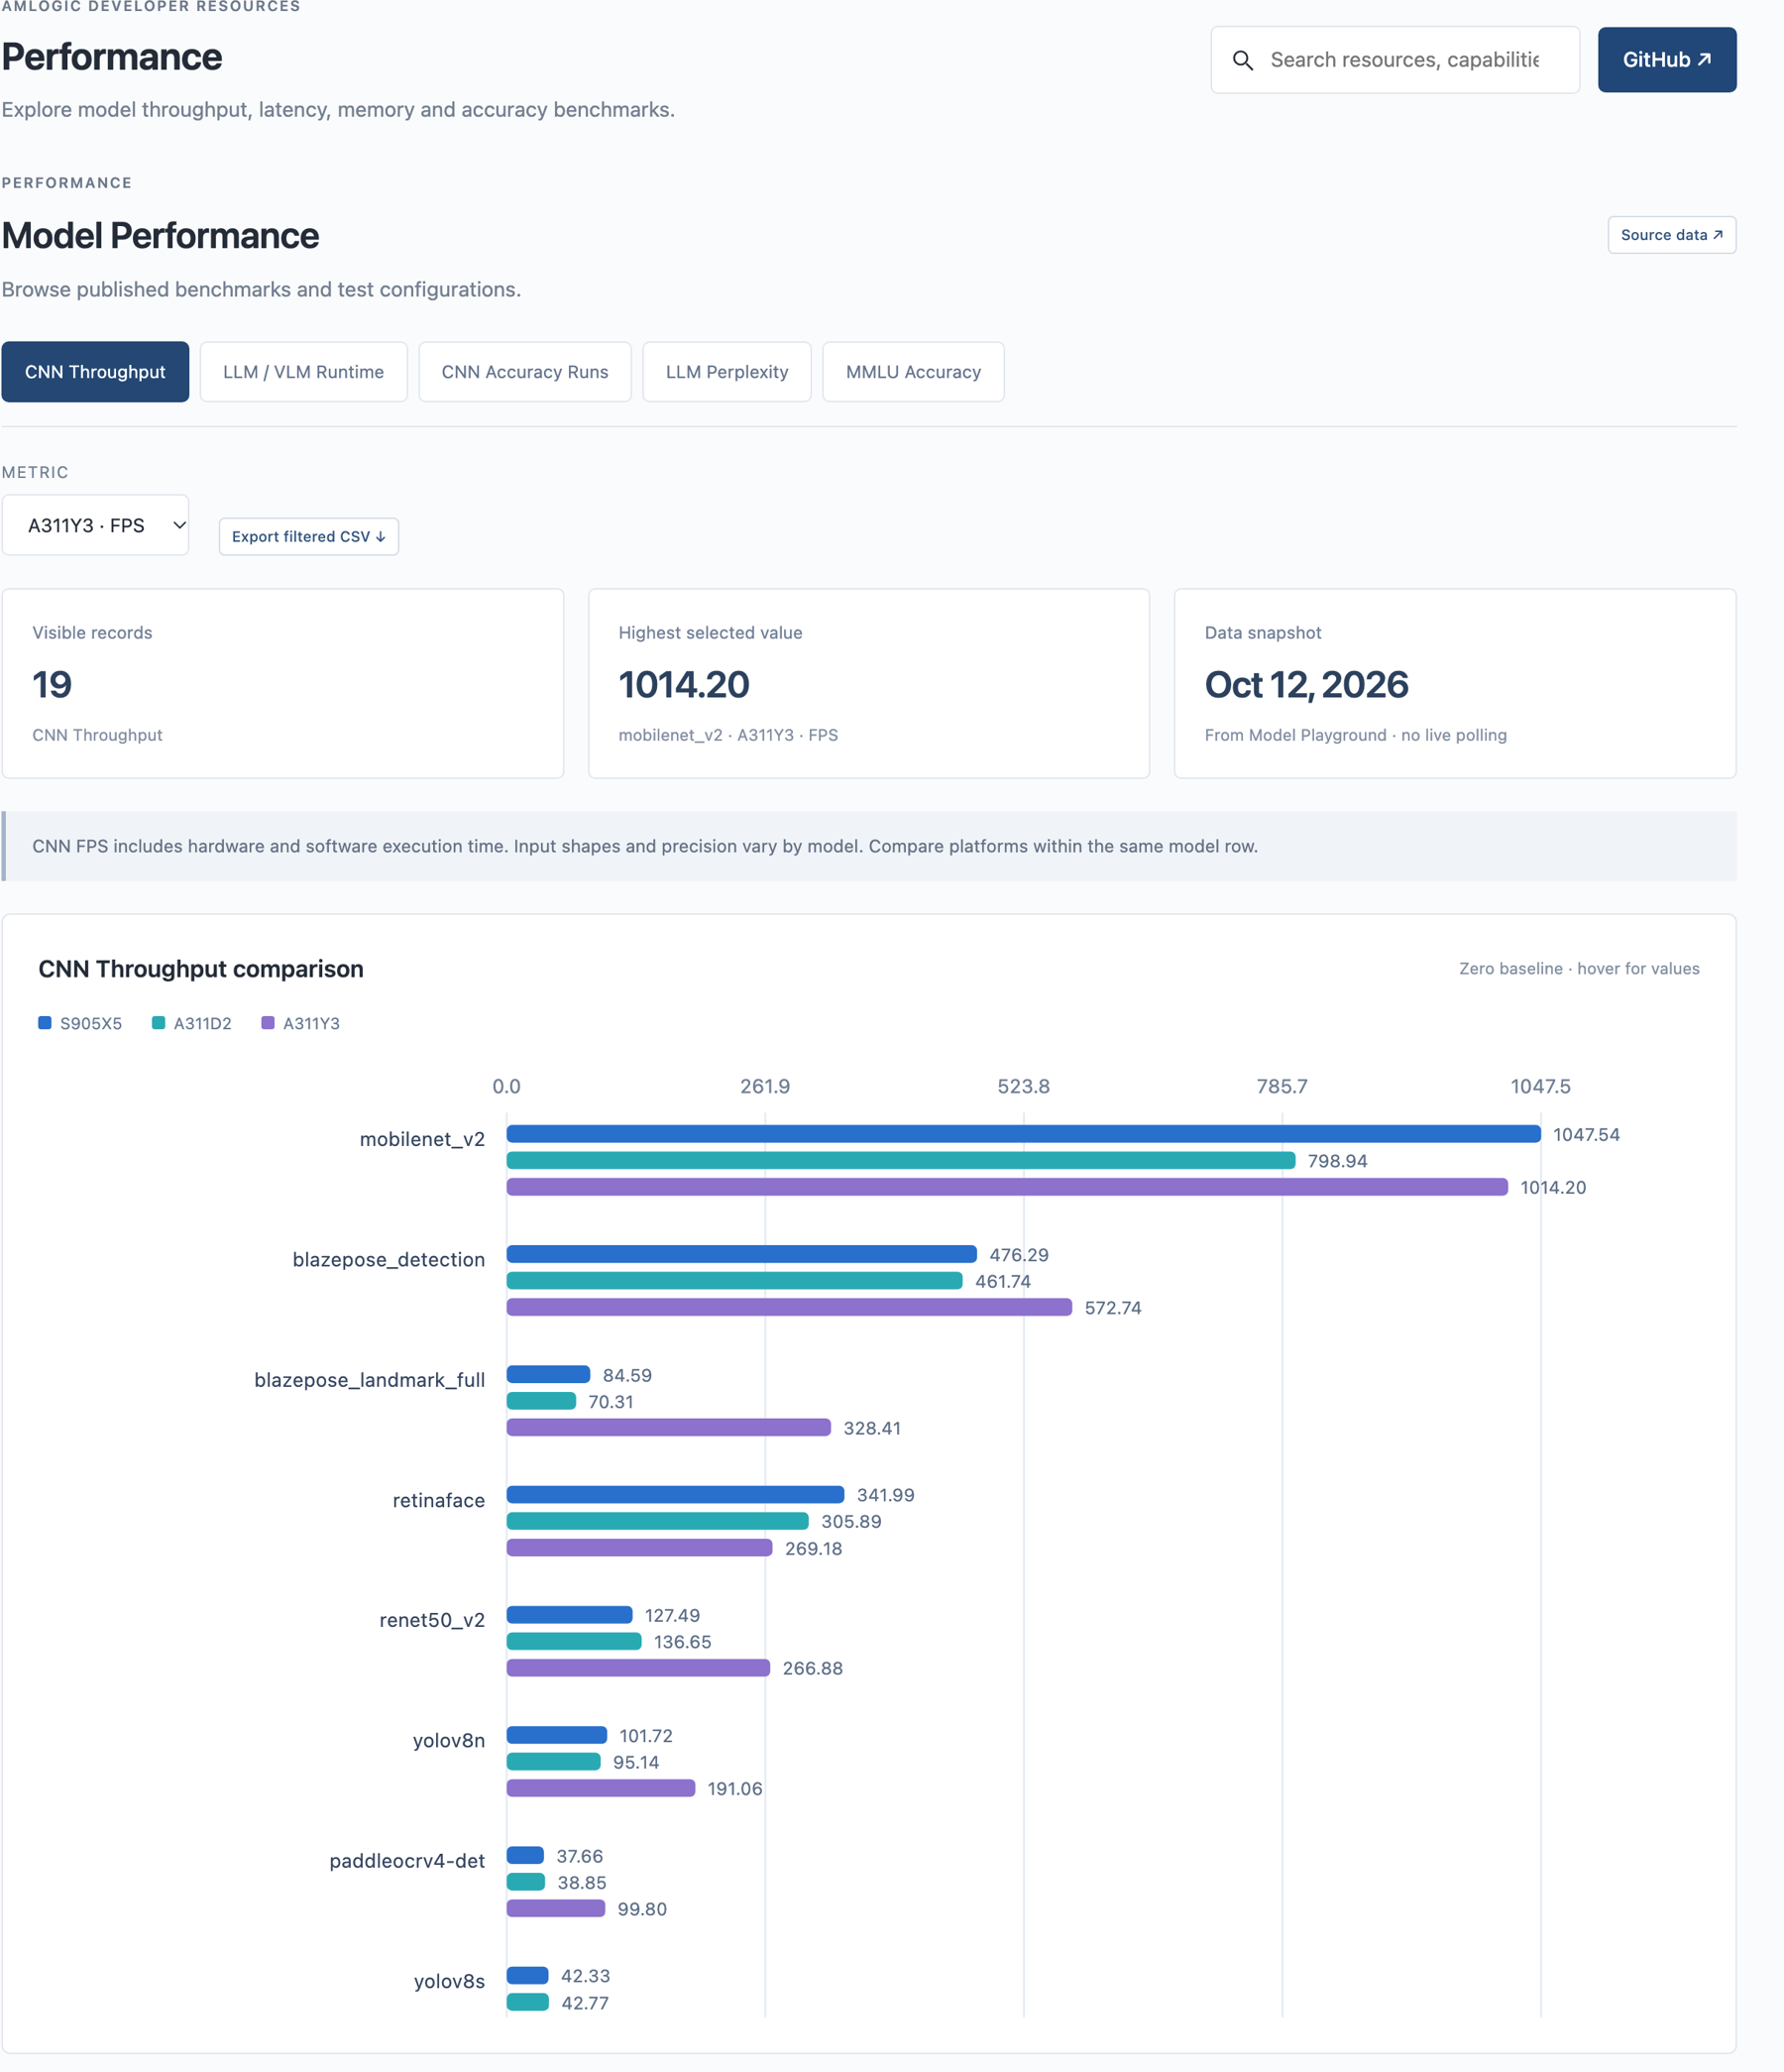
图 5 CNN 吞吐量实测:S905X5 / A311D2 / A311Y3 三平台对比(数据快照 Oct 12, 2026)
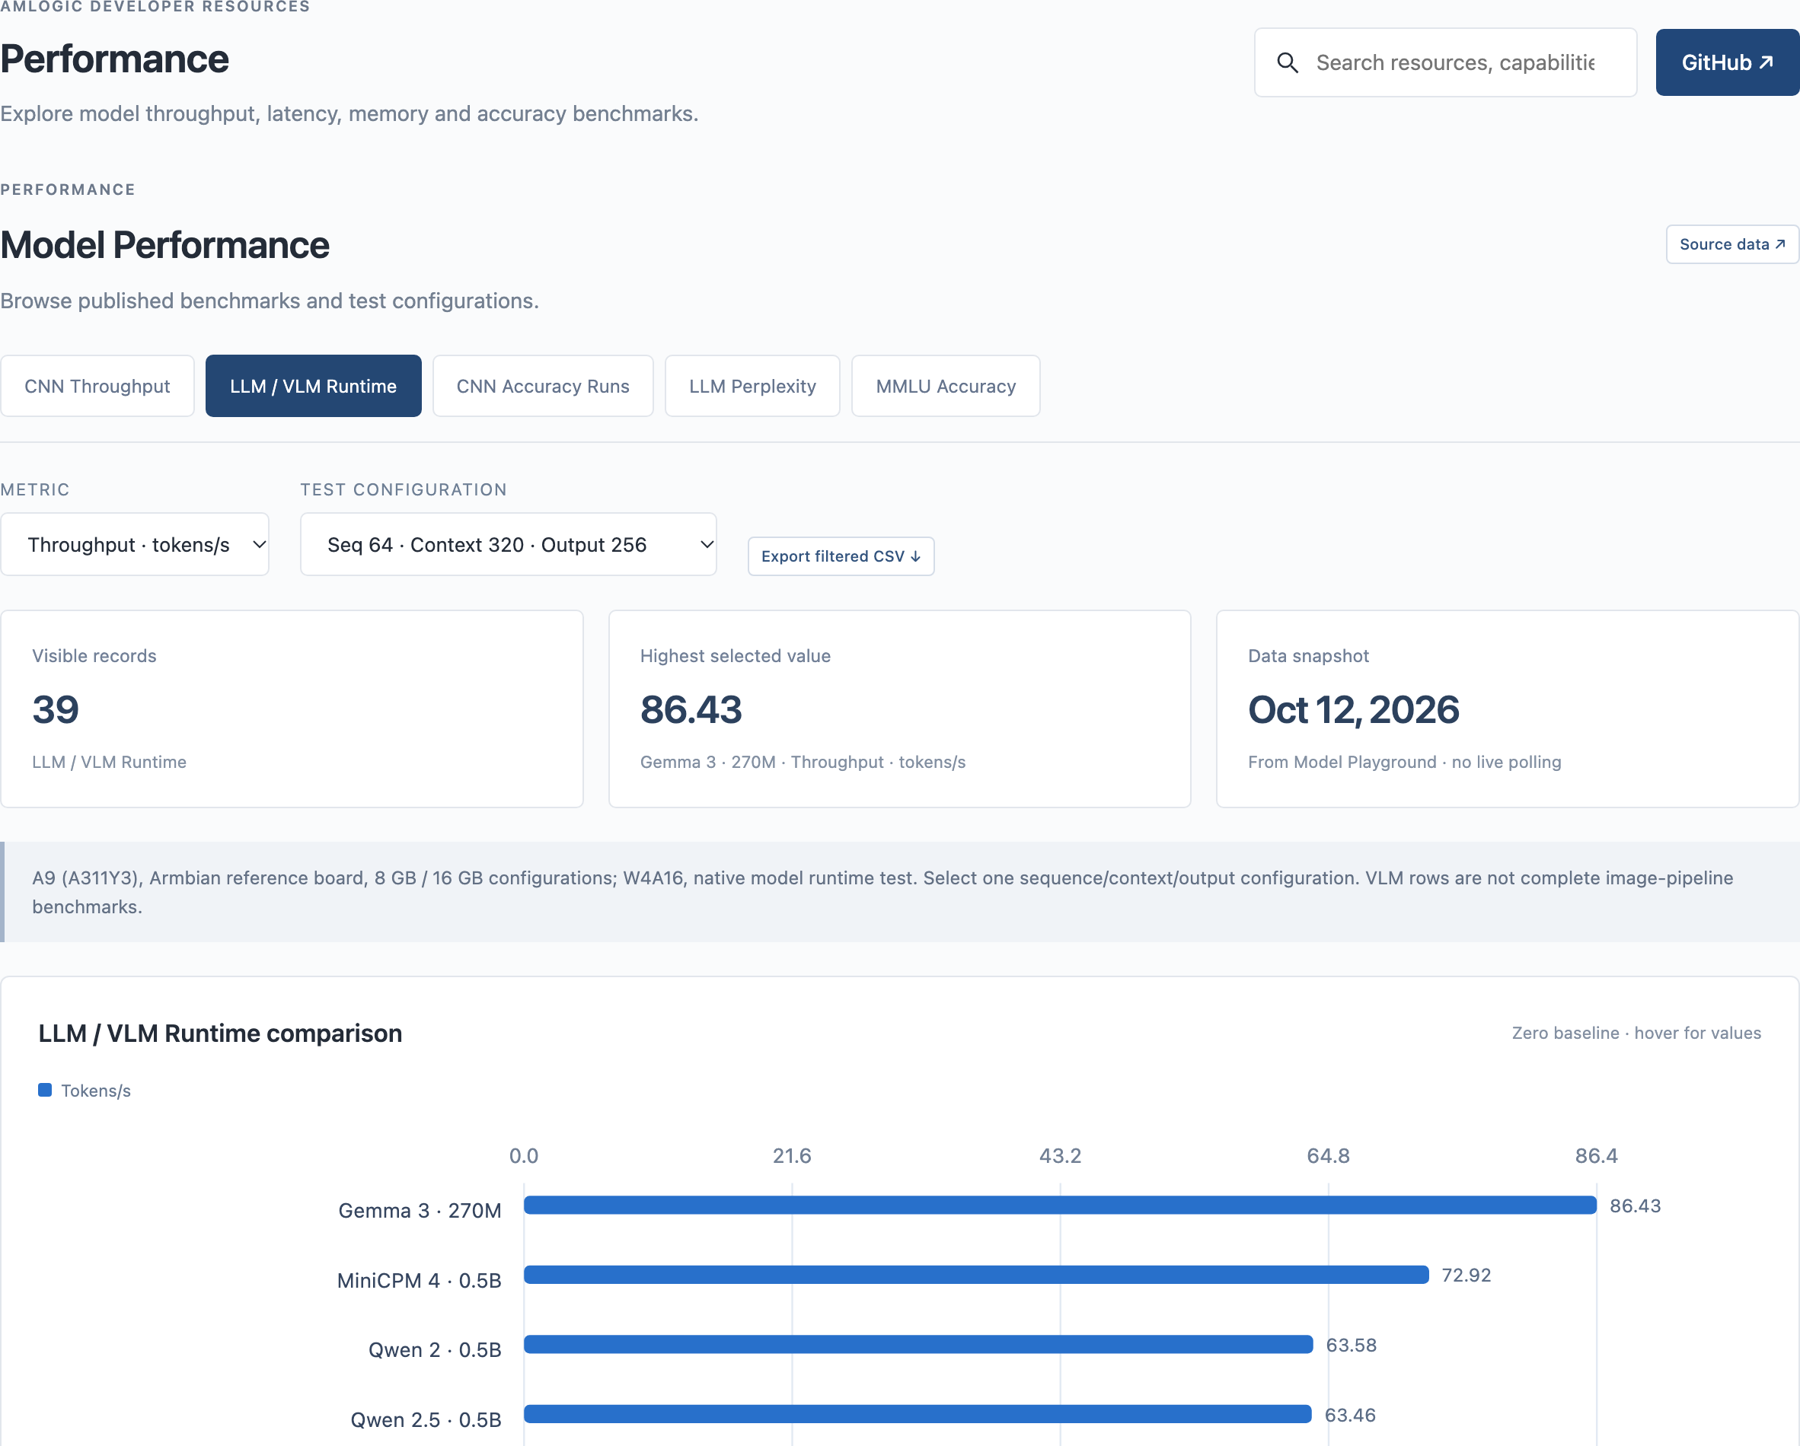
图 6 LLM/VLM 运行时实测:A311Y3 参考板各模型 tokens/s(W4A16)
六、Agent 方向:先把接口开放,场景逐步落地
Agent 部分,目前已经发布的是 Agent Client Integration 文档,说明 Agent Server 如何接入 PicoClaw、DeepSeek Harness 和 LangChain,底层走 OpenAI 兼容接口和工具执行循环。此外门户还列出了五个参考场景:AI NAS(媒体搜索、人脸搜索、内容摘要)、AI 购物(商品识别、搜索、推荐)、会议纪要(语音识别、说话人分离、摘要)、家庭语音助手(ASR、对话、TTS)和 OCR 翻译。需要说明的是,这五个场景目前都标注为“Planned Example / Coming Soon”,属于规划中、即将开放的示例,并非已交付功能。
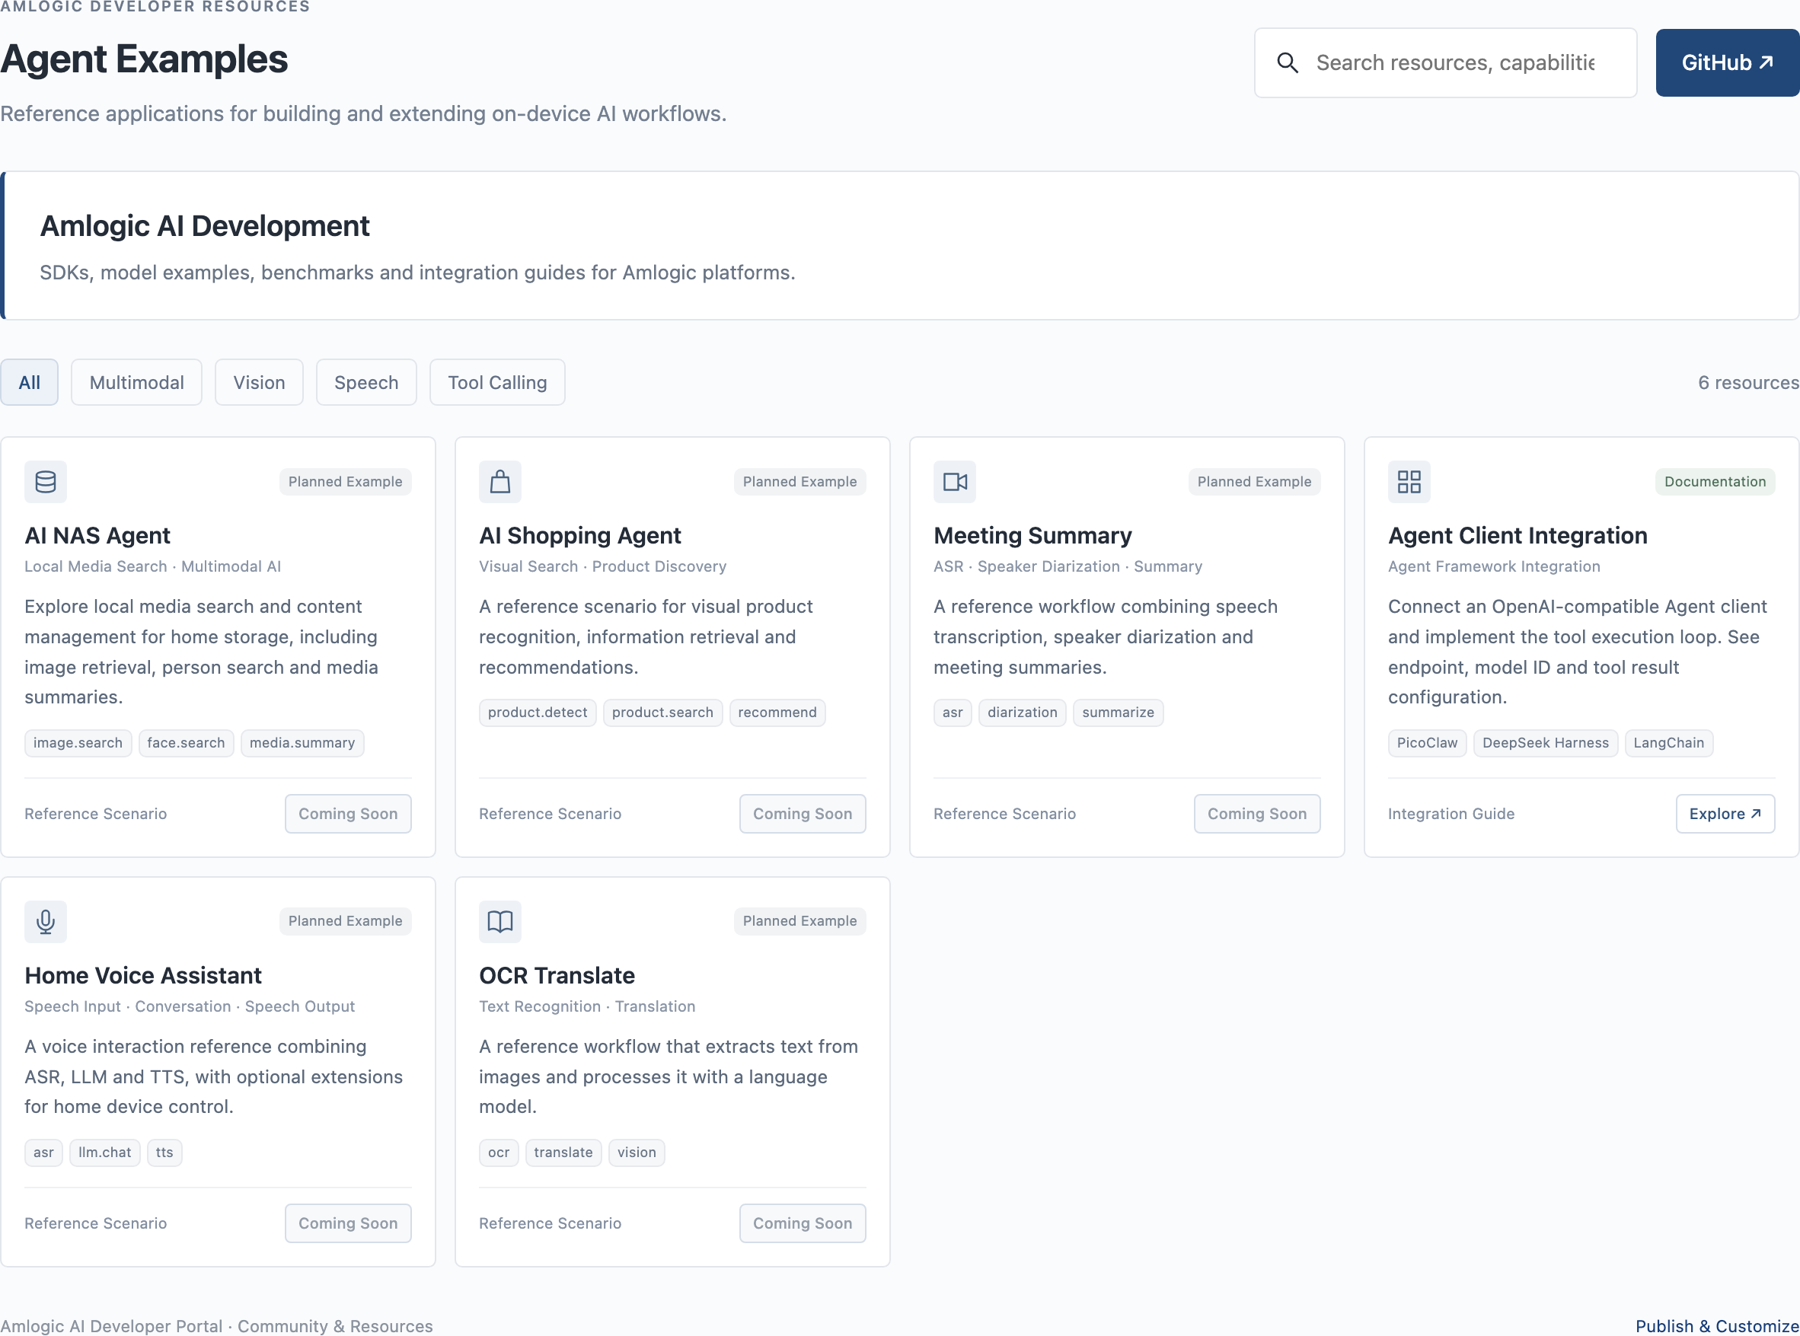
图 7 Agent Examples:集成文档已发布,五个参考场景为规划中
七、开源:11 个仓库,对接主流生态
Amlogic-NN 在 GitHub 上开放了 11 个仓库,主要工具以 Apache-2.0 协议开源。除了模型工具包、模型示例场和 Agent Server,还包括:amlnn-google-ai-ecosystem,对接 Google AI Edge 的 NNAPI、LiteRT 和 MediaPipe;amlnn-third-party-runtime,适配 NNStreamer、ExecuTorch、ONNX Runtime 和 MNN;aml-onnxruntime 是对微软 ONNX Runtime 的适配分支;amlnn-multibackend 则让没有 NPU 的 SoC 也能走 CPU/GPU 后端跑通。这意味着客户已有的模型和工程栈,大多数不用推倒重来。
结语:从一个模型开始,把产品跑起来
过去,端侧 AI 开发常常要在不同文档、网盘和技术支持之间来回找资料。现在晶晨把模型、工具链、性能数据和文档放到了同一个门户,并且把核心工具放到了开源社区。开发者可以从一个模型开始,在晶晨平台上把自己的端侧 AI 产品跑起来。





 每日经济新闻客户端